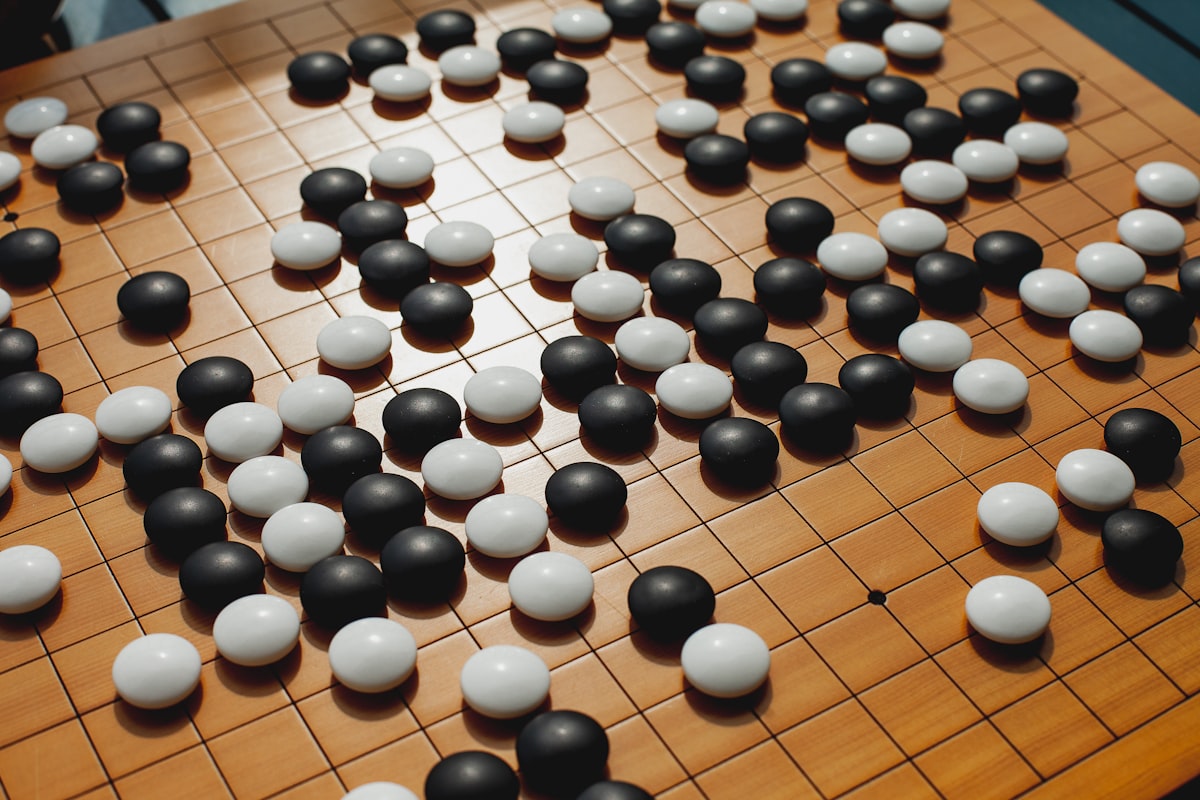
Nel 2016, durante una partita di Go trasmessa in diretta mondiale, un programma chiamato AlphaGo giocò la mossa 37. Una mossa che nessun giocatore umano avrebbe mai scelto. Una mossa che vinse la partita. Quella sera ha cambiato la storia dell’intelligenza artificiale.
C’è un gioco da tavolo inventato in Cina tremila anni fa che si chiama Go. Si gioca su una griglia di 19×19 intersezioni, con pietre bianche e nere. Le regole si spiegano in cinque minuti. La profondità è tale che nessun computer era mai riuscito a batterlo — non perché fosse troppo complicato da calcolare, ma perché richiedeva qualcosa che assomigliava all’intuizione. Per decenni, i ricercatori di intelligenza artificiale lo avevano usato come misura di ciò che ancora mancava alle macchine.
Nel 2016, un sistema sviluppato da DeepMind — si chiamava AlphaGo — ha cambiato questa storia. E insieme a una scoperta parallela nell’architettura delle reti neurali, ha costruito le fondamenta dell’AI che usiamo oggi.
AlphaGo e la mossa 37: il momento che ha cambiato tutto
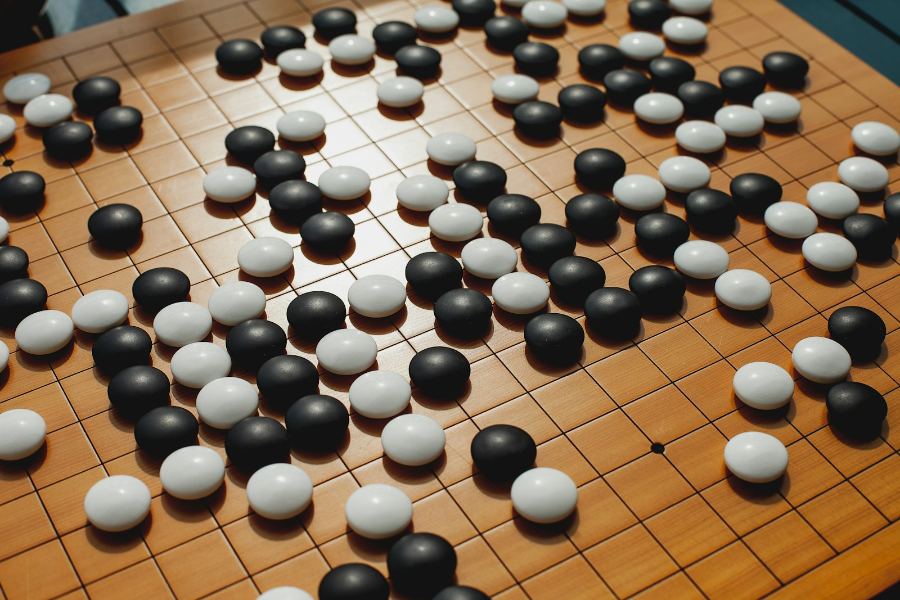
Seoul, marzo 2016. Secondo incontro della sfida tra AlphaGo e Lee Sedol, il più forte giocatore di Go del decennio. Nelle stanze del Four Seasons Hotel, i commentatori seguono la partita in diretta. Al trentasettesimo movimento, AlphaGo piazza una pietra nella quinta fila del lato destro del tabellone.
Silenzio.
Fan Hui, campione europeo di Go e unico professionista che AlphaGo aveva già battuto, guarda lo schermo. Poi dice: — È sbagliata. È una mossa umana sbagliata.
Nessun giocatore umano avrebbe mai giocato lì. La quinta fila è considerata troppo alta, troppo presto. È una posizione che non risponde alle urgenze immediate della partita, che ignora le convenzioni accumulate in migliaia di anni di pratica. I maestri giapponesi, coreani, cinesi avevano costruito intere filosofie attorno a queste regole non scritte. La mossa 37 le violava tutte.
Quattro ore dopo, era chiaro che AlphaGo aveva vinto quella partita. E che la mossa 37 era un capolavoro.
Lee Sedol uscì dalla stanza per qualche minuto. Non è dato sapere cosa pensò. Forse niente. Forse troppo.
Perché il Go era considerato inviolabile per l’intelligenza artificiale
Il Go era considerato inviolabile per l’intelligenza artificiale perché il numero di possibili configurazioni sulla scacchiera supera il numero di atomi nell’universo osservabile. Gli scacchi erano già stati risolti — Deep Blue aveva battuto Kasparov nel 1997 — ma quello era un gioco con uno spazio di ricerca gestibile. Il Go no. Nessun algoritmo brute-force poteva funzionare. Serviva qualcosa di diverso: serviva capire la posizione, non calcolarla.
DeepMind ci riuscì combinando reti neurali convoluzionali, apprendimento per rinforzo e simulazioni di partite. AlphaGo aveva studiato milioni di mosse umane, poi aveva giocato contro se stesso, affinando intuizioni che nessun essere umano gli aveva trasmesso esplicitamente. Aveva imparato a vedere il tabellone in modo che nessun maestro aveva mai visto — perché nessun maestro aveva mai avuto il tempo di giocare abbastanza partite contro qualcuno di altrettanto bravo.
La mossa 37 non era sbagliata. Era semplicemente fuori dal corpus di conoscenza umana disponibile.
AlphaGo Zero: quando l’AI ha smesso di imitarci
Un anno e mezzo dopo, DeepMind pubblicò AlphaGo Zero.
La differenza con il predecessore era radicale: Zero non aveva studiato nessuna partita umana. Partiva da zero — da regole e niente altro — e giocava contro se stesso. Tre giorni dopo, era già più forte di AlphaGo. Quaranta giorni dopo, era il più forte giocatore di Go che fosse mai esistito.
Questo è il momento che conta davvero, più della sconfitta di Lee Sedol. AlphaGo Zero dimostrava che l’intelligenza artificiale non aveva bisogno di imitare gli esseri umani per superarli. Poteva costruire la propria conoscenza da principi primi. Poteva scoprire da sola cose che noi non avevamo mai scoperto — e forse non avremmo mai scoperto.
L’AI aveva smesso di essere uno specchio.
Il Transformer: l’altra fondazione dell’AI moderna
Nello stesso anno — il 2017 — otto ricercatori di Google Brain pubblicavano un paper il cui titolo era una dichiarazione: Attention Is All You Need.
Ne ho scritto in un altro articolo, dal lato della cognizione: come l’attenzione, la gerarchia, il contesto siano strutture universali dell’elaborazione dell’informazione, biologica o meccanica. Ma vale la pena tornare sul Transformer da un’angolazione diversa, quella storica. Perché la coincidenza temporale con AlphaGo non è casuale — è il segno che qualcosa stava convergendo.
Il Transformer non insegnava all’AI a giocare meglio. Le dava la struttura per pensare in linguaggio. Ogni parola guardava ogni altra parola in una frase, pesandone la rilevanza. Il significato emergeva non dalla sequenza, ma dalle relazioni. Era un’architettura che scalava: più dati, più potenza di calcolo, più capacità. GPT, BERT, poi Claude, Gemini — tutto passa per quella scoperta.
Se AlphaGo aveva liberato l’AI dall’imitazione, il Transformer le aveva dato la voce.
Due mosse che hanno ridefinito l’intelligenza artificiale
Le due mosse si completano.
AlphaGo Zero ha dimostrato che un sistema può generare conoscenza autonomamente, senza appoggiarsi all’esperienza umana come punto di partenza. Ha aperto uno spazio in cui l’AI non è più uno strumento che amplifica ciò che già sappiamo, ma un agente che esplora ciò che non sappiamo ancora.
Il Transformer ha dato a quel tipo di intelligenza la capacità di operare sul linguaggio — il mezzo in cui viviamo, pensiamo, tramandiamo. Ha reso possibile che quell’intelligenza parlasse con noi, scrivesse per noi, ragionasse dentro i nostri problemi.
Insieme hanno ridefinito il campo. Non perché abbiano costruito una macchina che pensa come noi — ma perché hanno costruito qualcosa che pensa diversamente da noi e può comunque comunicare con noi.
Fan Hui: quando AlphaGo cambia un giocatore umano
Fan Hui, il commentatore che aveva detto che la mossa 37 era un errore, in seguito ha detto qualcosa di più interessante. Ha detto che dopo AlphaGo ha ricominciato a giocare a Go, e che lo faceva in modo diverso. Guardava il tabellone con occhi nuovi. Alcune mosse che prima scartava per istinto ora le prendeva in considerazione.
Un’AI lo aveva cambiato come giocatore.
Non so se sia una storia consolante o inquietante. Probabilmente è entrambe le cose — come tutte le storie che guardano dove gli altri non guardano.
Leggi anche: Asimov e le leggi della robotica — AI e marketing intelligente
Per approfondire: AlphaGo su Wikipedia racconta la storia completa del programma DeepMind.
Il confine tra imitazione e identità propria è uno dei temi che attraversa anche Anno Domini, il mio primo romanzo: un libro in cui i protagonisti si ritrovano a fare i conti con ciò che succede quando le certezze su se stessi smettono di reggere.